
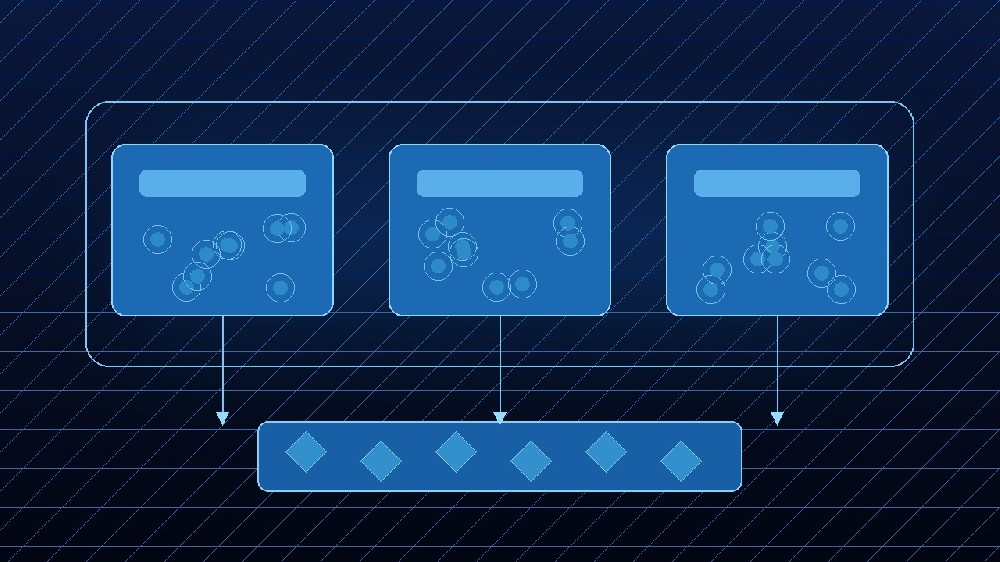
给每个团队一套专属 Kubernetes 集群,往往带来超出实际需要的隔离;而把一个集群共享给很多团队,协调成本又会随团队数量上升:CRD 版本冲突、RBAC 重叠,以及没有干净的办法把 GPU 容量切成团队级预算。到一定规模,团队会要求独立集群,只为了拿回自主权——代价是硬件被切碎。
NVIDIA 给出的模式是在不拆硬件的前提下保留团队自主权:一个带 GPU 池的控制面集群,按团队配额做 GPU 共享,再为每个团队提供独立的 Kubernetes 控制面,包含 API server、控制器、数据存储、syncer 与调度器。整套方案只需要两个开源工具:KAI Scheduler 与 vCluster。
KAI Scheduler 是面向 AI 负载设计的拓扑感知 Kubernetes 调度器,强调健壮、高效与可扩展,能管理包括数千节点在内的大规模 GPU 集群与高吞吐负载,可以按需为工作负载动态分配 GPU 资源,并能与默认的 kube-scheduler 并存:声明 schedulerName: kai-scheduler 的 pod 交给它调度,其余仍走 kube-scheduler。vCluster 则在自有基础设施甚至裸机上提供完全隔离的租户集群,每个租户集群拥有自己的 API server、CRD 与 RBAC,体验与专属集群没有区别,但共享底层节点与硬件;虚拟化控制面对租户不可见,没有共享控制面节点、没有集群内 agent pod,环境之间也没有横向通路。
演示环境刻意做得很小,便于复现:Nebius 上的 NVIDIA Brev GPU 实例,单张 NVIDIA L40S(48 GB 显存)、40 vCPU、160 GiB 内存、256 GiB 磁盘,Ubuntu 24.04.4 LTS,MicroK8s v1.36.2(Brev 已预配 GPU addon,会安装 NVIDIA GPU Operator 到 gpu-operator-resources 命名空间),KAI Scheduler v0.16.4,vCluster CLI 0.35.1。作者说明,在 GKE、EKS、AKS、原生 k8s 或 k3s 上集群创建与 GPU Operator 安装步骤会有差异,但只要 Kubernetes 上跑着 NVIDIA GPU Operator 且启用了 CDI,从安装 KAI Scheduler 开始的步骤完全一致。
配额与隔离的落地方式很直接。KAI Scheduler 用 Queue 这个 CRD 表达“组织到团队”的层级:示例建一个父队列 ml-org,GPU 总预算为 1 张卡,再建 team-nlp、team-vision、team-recommender 三个子队列,每个保证 0.33 张 GPU、上限 1 张,空闲时可以涨到整卡。三个参数的含义分别是:quota 为保证下限、limit 为允许上限、overQuotaWeight 决定盈余如何分配。随后为每个团队起一个 vCluster,其中最关键的设置是 setOwner: false —— KAI Scheduler 的 pod-grouper 需要沿所有权链(Job 到 Pod、Deployment 到 ReplicaSet 再到 Pod)自动分组工作负载,禁用 vCluster 的 owner 改写,调度器才能看到真实的层级关系。
演示的验证目标是:三个团队各自在自己的租户集群里运行真实的 GPU pod,全部共享同一块物理 GPU,并且每个团队只能看到自己的工作负载;同一套做法可以放大到数百个 GPU 节点、数十个团队的集群,只需扩展节点池、队列层级与租户集群数量。边界也需要说明:共享节点(shared-nodes)模型适合受信任的内部团队;如果租户不受信任、需要在节点、网络与存储层面做隔离,同一模式可以扩展到 vCluster 的 private nodes 模式。

 WeChat
 Profile