业务目标
明确要解决的性能、扩容、稳定性、覆盖、互连或运维问题,并确认上线优先级。
按品牌与产品线快速定位,减少查找成本。
进入品牌页查看对应产品与项目资料;如已配置子分类,可在下方快速进入。
进入品牌页查看对应产品与项目资料;如已配置子分类,可在下方快速进入。
进入品牌页查看对应产品与项目资料;如已配置子分类,可在下方快速进入。
进入品牌页查看对应产品与项目资料;如已配置子分类,可在下方快速进入。
进入品牌页查看对应产品与项目资料;如已配置子分类,可在下方快速进入。
随着企业AI应用规模扩大,开发者需要将分散的管道整合起来。MiniMax M3拥有4280亿参数的混合专家多模态模型,支持百万Token级上下文窗口,能同时处理文本、图像和代码。NVIDIA将M3部署在加速基础设施上,通过NIM提供优化的推理服务,使企业能在生产环境中高效运行这一规模的模型。M3采用创新的MoE架构,每个Token仅激活部分
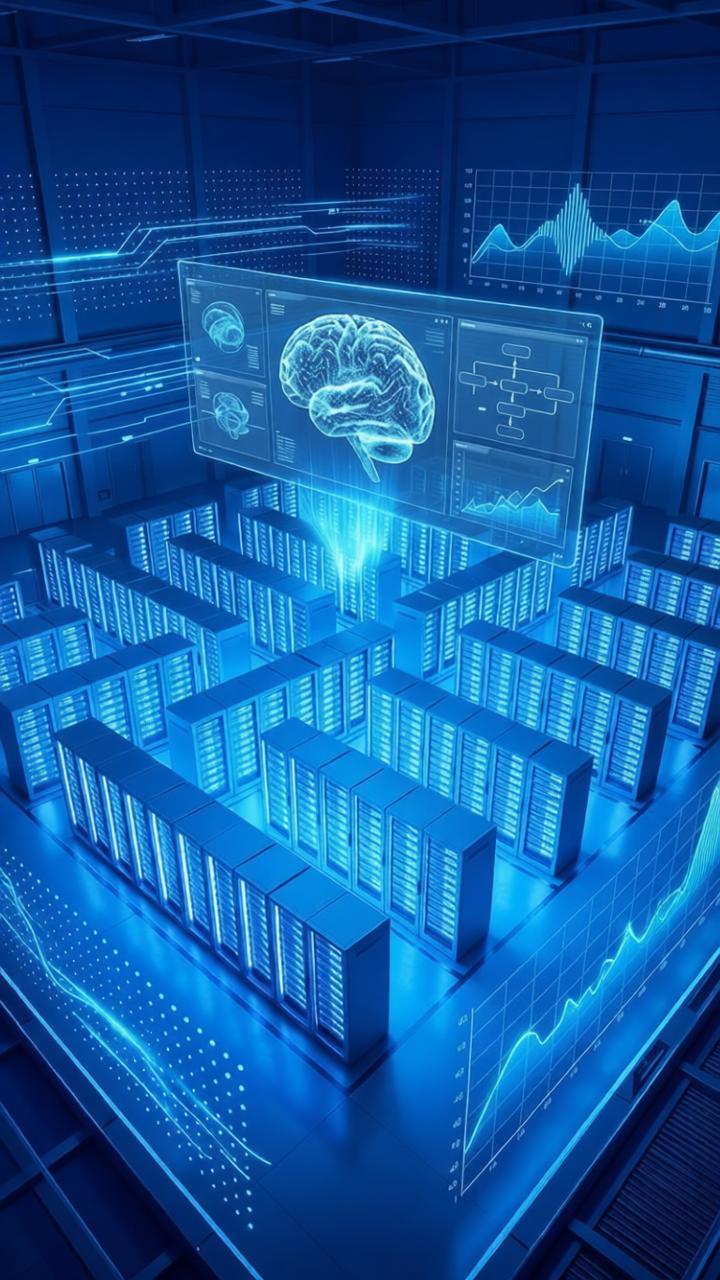
随着企业AI应用规模扩大,开发者需要将分散的管道整合起来。MiniMax M3拥有4280亿参数的混合专家多模态模型,支持百万Token级上下文窗口,能同时处理文本、图像和代码。NVIDIA将M3部署在加速基础设施上,通过NIM提供优化的推理服务,使企业能在生产环境中高效运行这一规模的模型。M3采用创新的MoE架构,每个Token仅激活部分
如果你正在评估对应场景,我们可以基于当前方案继续细化产品组合、测试路径与实施节奏。
浏览更多相关方案查看方案背景、关键能力与适配场景,帮助你更快判断下一步应进入测试、咨询还是部署阶段。
随着企业AI应用规模扩大,开发者需要将分散的管道整合起来。MiniMax M3拥有4280亿参数的混合专家多模态模型,支持百万Token级上下文窗口,能同时处理文本、图像和代码。NVIDIA将M3部署在加速基础设施上,通过NIM提供优化的推理服务,使企业能在生产环境中高效运行这一规模的模型。
M3采用创新的MoE架构,每个Token仅激活部分专家参数,在保持模型容量的同时降低计算成本。配合TensorRT-LLM的优化——包括动态批处理、KV缓存管理和FP8量化——M3在实际推理任务中实现了显著吞吐量提升和延迟降低。百万级上下文意味着模型能处理整本书籍、完整代码仓库或长时间多轮对话。对于企业级RAG、代码生成和复杂推理任务,MiniMax M3与NVIDIA加速基础设施的结合提供了一种兼顾模型规模与推理效率的实用方案。
在进入报价、测试或实施前,先把业务目标、现网条件和风险边界整理清楚。
明确要解决的性能、扩容、稳定性、覆盖、互连或运维问题,并确认上线优先级。
整理拓扑、服务器/交换机型号、接口速率、链路距离、供电散热和现有管理平台。
确认是否需要 PoC、兼容测试、吞吐测试、时延测试、无线覆盖测试或故障切换测试。
确认交付窗口、责任分工、备件策略、培训需求、验收指标和后续扩容路径。
企业网络、AI 基础设施与高性能连接解决方案合作伙伴
工作日 09:00 - 18:00,支持售前咨询、项目对接与方案沟通。
立即咨询通过微信或资料二维码,快速获取咨询与企业信息。
 WeChat
微信咨询
 Profile
企业资料