
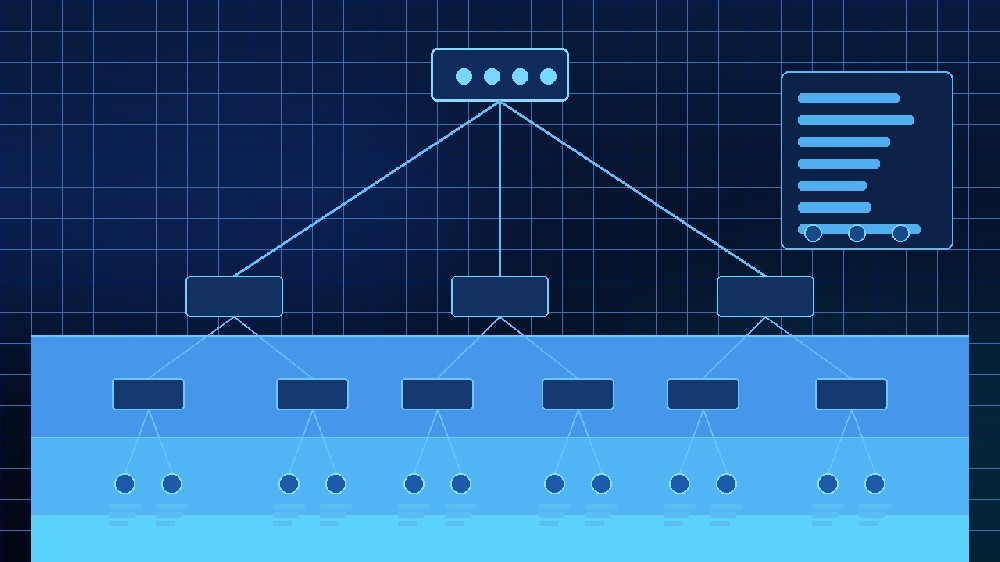
NVIDIA 开源了集群拓扑发现工具 Topograph,用于把物理网络与加速器互连关系,翻译成工作负载管理器真正能消费的格式:Kubernetes 节点标签、Slurm 拓扑配置、Slinky ConfigMap 或 Node Feature Discovery 资源。
问题由来已久。AI 工厂是受功耗约束的系统,只有把 GPU 工作负载放对位置才能拿到最大产出。放置不当会割裂拓扑域,把通信压到共享链路上:吞吐下降、作业成本上升,GPU 明明占着已分配电力,却在等数据。训练与推理中的 GPU 持续交换数据,分布式负载天然受益于通信局部性,而调度器只有在掌握当前、准确的 GPU 与 fabric 关系时,才可能做出正确放置。
Topograph 把这件事拆成两个概念:provider 与 engine。provider 从云厂商 API 或本地 fabric 系统发现拓扑,并归一化为统一模型;engine 再把该模型写成各调度器期待的形式。由于视图会按需重建、并在监听到集群变化时刷新,调度器拿到的不是人工维护的快照。
与调度器衔接的部分比较务实。默认 Kubernetes 调度器本身不会发现物理互连层级,Topograph 用变深度的标签族表达 fabric 层级(tier-0 为最靠近节点的叶子交换机,逐级向外),用两级层次表达加速器域与子域。KAI Scheduler 与 Kueue 可以基于同一批标签做拓扑感知的 gang 放置:required 注解把整个 gang 限制在单一 tier-1 域内,preferred 注解则尽量把 Pod 收拢到某个 tier-0 域。
拓扑为什么值得单独建模,可以从带宽看出量级差异。第五代 NVLink(Blackwell,如 GB200/GB300)为每 GPU 提供 1.8 TB/s 双向带宽,第六代(Vera Rubin)提升到 3.6 TB/s,经专用 NVLink Switch fabric 提供无阻塞的全互联;相比之下,跨域流量要经过共享链路与交换机。把紧耦合负载摊到远端域,等于主动制造争用与延迟。
部署门槛不高:Kubernetes 1.27 及以上、Helm 3.10+ 或 4.x、具备 kubectl 权限即可。生成请求是异步的,提交返回 202 与请求 ID,处理中仍为 202,完成后 200 返回结果;聚合延迟是必需环节,典型值 15 秒,重复的相同请求会重置尾部计时器只处理一次。没有生产硬件时,可以用模拟模型描述节点与交换机层级,配合 Kind/KWOK 助手生成虚拟 Kubernetes 节点。Crusoe 等云 provider 已有可用集成,provider 接口开放,运维团队可以为自己环境新增实现并回馈上游。

 WeChat
 Profile