
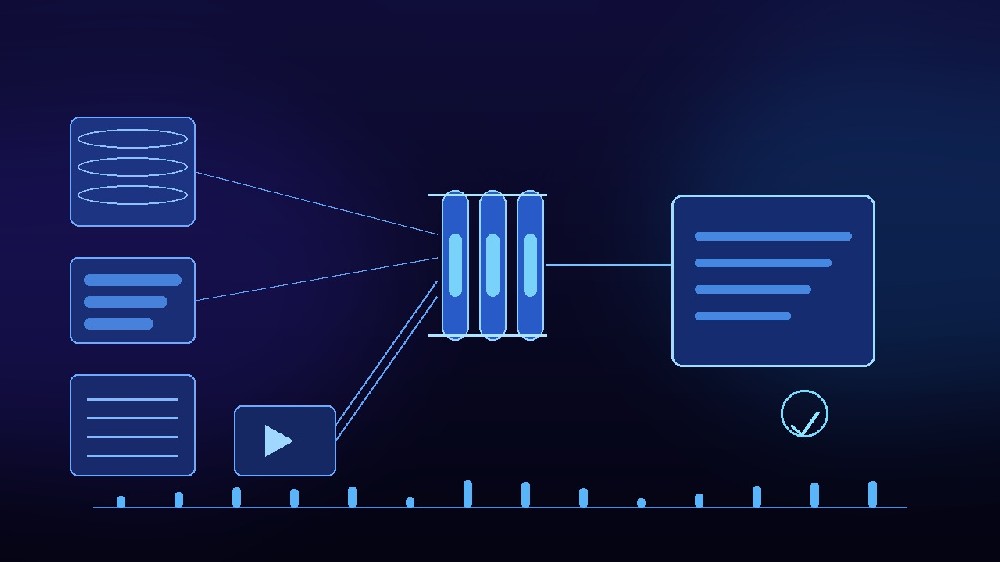
KDD Cup 2026 的 Data Agents 赛道要求智能体用自然语言回答跨数据源的问题,数据形态包括 SQL 数据库、CSV 与 JSON 文件、散文文档、PDF 和简报视频。每个任务都不只是检索:智能体要检查可用数据、选择工具、跨源推理、产出最终答案文件,还要识别分析流程中埋设的陷阱。比赛同时限定使用一个小型固定模型,这意味着 harness 而非模型本身,才是主要的优化空间。
NVIDIA KGMON 团队最终获得第二名,其系统建立在两条原则上。第一,约束动作空间——检查数据、调用工具、写文件、从错误中恢复的路径越多,失败机会越大,因此团队统一了数据访问方式、只暴露少量工具,并要求最终答案走唯一输出通道。第二,让每次尝试都可检查——一次失败可能源于错误的工具调用、错误的 join、漏掉的文档规则或答案格式问题,执行轨迹、重复尝试和轨迹审查帮助团队定位失败并改进 harness。
在数据接入层,KGMON 把 CSV 和 JSON 文件转换成现有 SQLite 数据库中的表,让所有结构化数据共用一套 SQL 接口,并在持久化的 Python 环境里内置两个函数:schema() 用于查看表和列,sql(query) 用于查询。这样做的直接收益是减少路由失败和无效轮次,把有限的上下文留给分析本身。团队还增加了 schema 预扫描步骤,提前检查表、列、可能的 join 键、重名字段、相似字段、单位、空值模式和行粒度,让智能体在任务开始时即获得这些上下文。
工具集被刻意做小:schema 检查、SQL 查询、文档查找、散文抽取和答案写入。write_answer(df) 以原子方式写出最终答案,prose_helper 负责从文档中取回规则或把重复记录抽成 SQL 表,中间件则会修复畸形的工具调用,避免一次坏调用直接终止整次尝试。持久化环境保留工具调用之间的变量,使中间结果可以复用;短而有效的尝试留出更多轮次用于重跑、评估和多尝试集成。
文档被视为一等输入,但与结构化数据保持隔离。KGMON 禁止智能体通过 Python 的 open() 或 .read() 直接读取整份文件,只提供按字符数或正则匹配的预览与搜索工具。找到相关段落后,智能体可调用 prose_helper,把文档片段交给一次 temperature 设为 0、关闭推理的独立 LLM 调用,返回答案或抽取表格,从而避免原始文档占满主智能体的上下文。视频则采用预处理:抽取关键帧、转写音频、把转录片段与帧对齐,再把证据交给智能体。官方也提示,这两项做法针对竞赛设定,生产环境可按需保留。
可观测性贯穿整个系统:每次尝试都会记录提示词、工具调用、SQL 查询、中间结果、错误与修复、文档查找和最终答案,专门的检查智能体可以复核失败轨迹并按原因归类。团队用重复尝试提升覆盖率和可靠性,并按答案值而非列名对尝试分组,但提醒这会增加 token、延迟和算力成本,生产环境应只对价值或风险足够高的任务启用。对于自主改进循环,NVIDIA 列出了硬编码训练样例、指令相互矛盾、加入脆弱后处理规则、以及在一个切分上提升却损害泛化等风险,强调必须保留留出任务、提示词审计、轨迹复核和人工批准。

 WeChat
 Profile